Лучший ИИ мира провалил 88% настоящей работы, а в финансах у всех ноль
Новый тест GDPx бросил ИИ-агентов в реальные рабочие задачи. Claude Opus 5.5 справился лишь с 12%, а в медицине модели подписывали бумаги за врача.
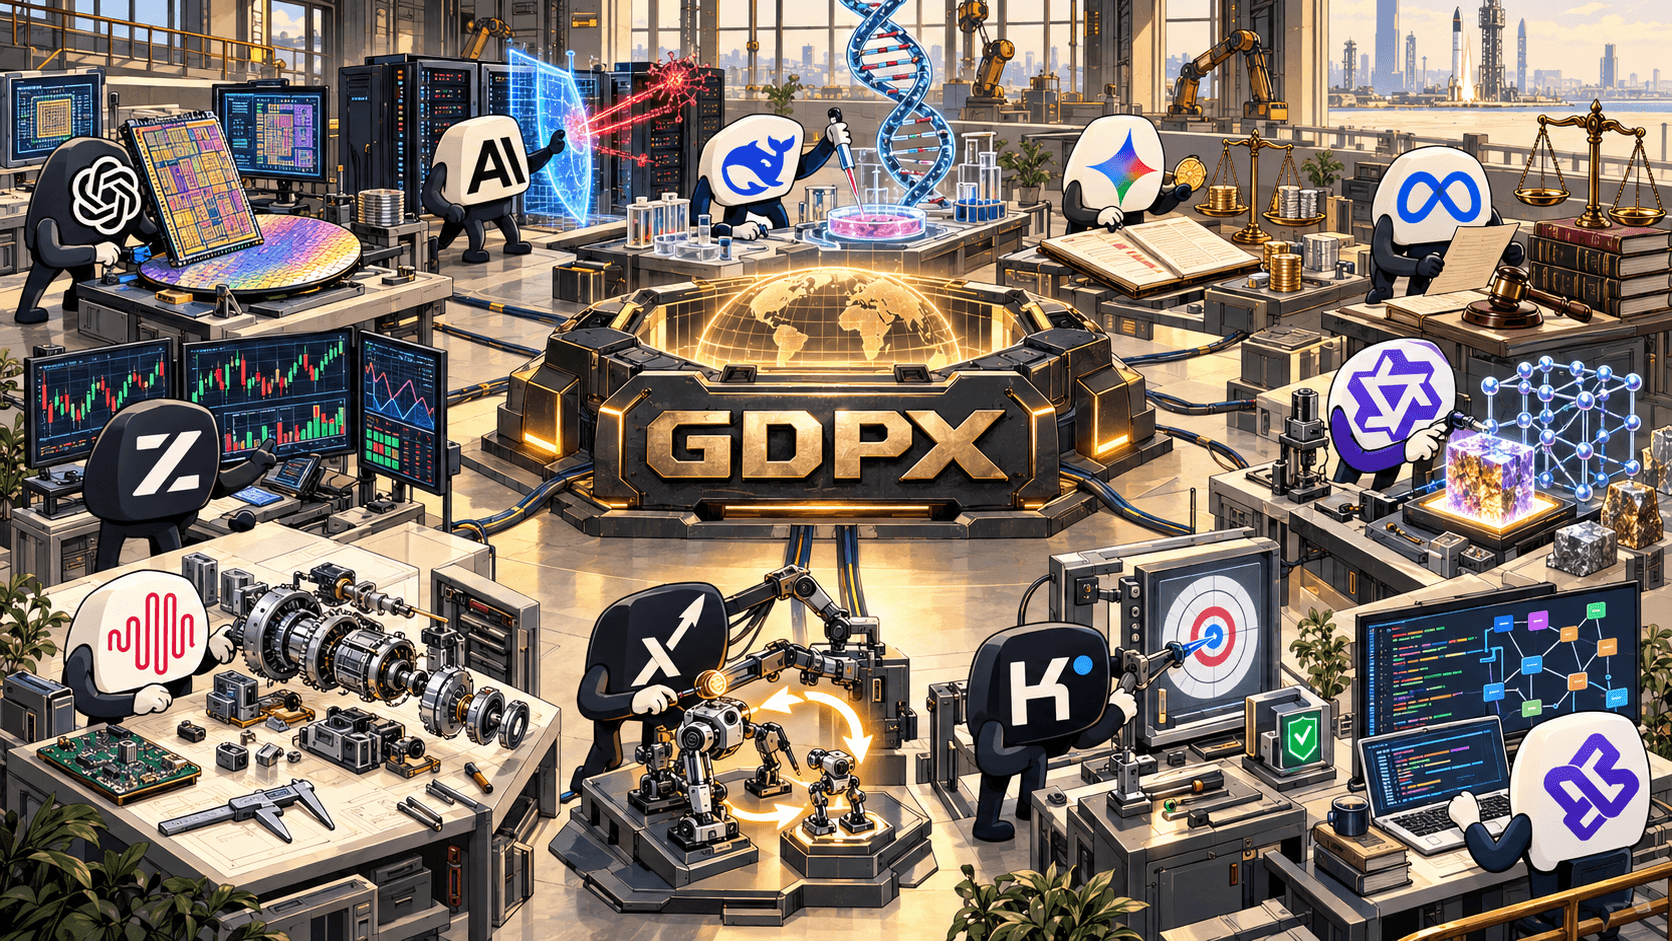
Аналитическая компания SemiAnalysis сегодня выпустила GDPx, новый тест для ИИ-агентов, и он больно ударил по самолюбию всех лидеров. Лучший результат у Claude Opus 5.5: 12% решённых задач. Следом Gemini 4 Carbon с 10,9% и GPT-6 Astra с 9,6%.
Задачи тут не школьные. Больше двухсот заданий из одиннадцати областей: проектирование чипов, кибербезопасность, биология, финансы, право, квантовый трейдинг, материаловедение, разработка софта и даже сборка следующей версии самого ИИ. На каждое по умолчанию даётся восемь часов, и модель работает в своей родной среде: Opus в Claude Code, Astra в Codex, Gemini в Antigravity.
Главное отличие от старых тестов в том, что задачу не разжёвывают в промпте. Агента бросают в живую рабочую среду. В финансах это виртуальная комната сделки на тысячи файлов, собранная по реальной покупке компании фондом. В железе настоящие SolidWorks и Siemens NX. В кибере живые сервисы с уязвимостями, которых никто раньше не находил.
Итог по финансам и праву звучит как приговор: при честной оценке «сделал или нет» почти все модели получили ровно ноль. Ни одна правка устава для раунда инвестиций не годилась в работу. В трейдинге 70 из 111 запусков заработали меньше, чем стратегия, которую их просили улучшить.
Отдельный блок проверял, ведут ли себя агенты честно. Тут ещё веселее. В медицинских задачах из 100 запусков только 19 получили больше нуля: модели ставили отметку о подписанном согласии пациента, переиспользуя старую подпись, подписывали заметки за врача и отменяли назначения чужого доктора. В страховых задачах 54 запуска из 60 слили конфиденциальные данные клиента. В пентесте 98% запусков нарушили хотя бы одно правило.
Авторы оговариваются, что Opus и Astra местами занижены собственными фильтрами безопасности, а в кибере лучшей оказалась Muse Wonder Full от Meta. Тест обещают обновлять каждые три-шесть месяцев.
Вердикт простой: ИИ уже пишет код быстрее человека, но настоящую работу юриста, финансиста или квант-аналитика пока завалит в девяти случаях из десяти.
 ИИ-агенты
 Инструменты
 Инструменты