Claude Opus 5.5 возглавил новый рейтинг ИИ-моделей Artificial Analysis
Anthropic обошла OpenAI на один балл в пятой версии индекса, но GPT-6.1 Sol почти так же умён и стоит в восемь раз дешевле.
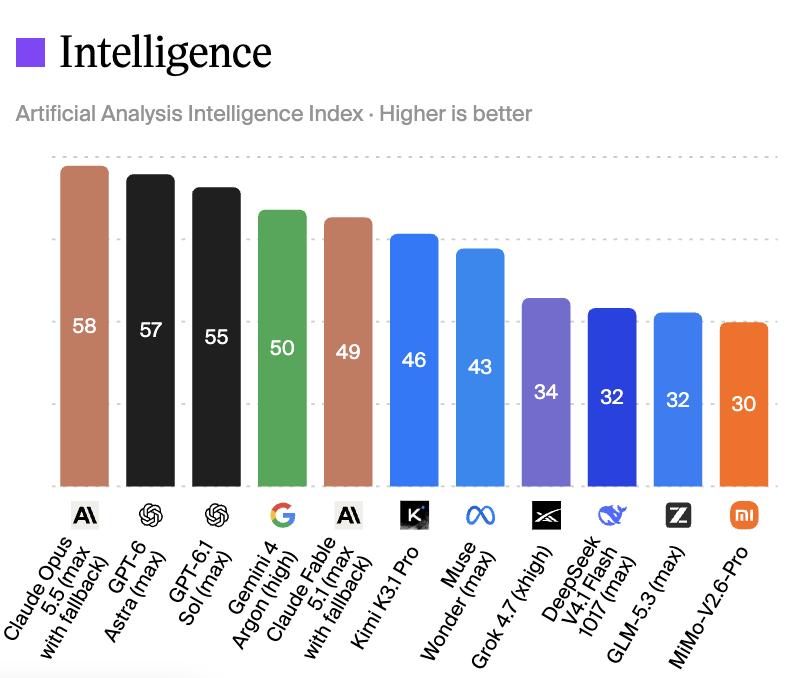
Artificial Analysis, независимая компания, которая гоняет ИИ-модели по одним и тем же тестам и сводит результаты в общий балл, выпустила пятую версию своего индекса. Первое место занял Claude Opus 5.5 от Anthropic с 58 баллами. GPT-6 Astra от OpenAI отстал всего на балл, GPT-6.1 Sol набрал 55, Gemini 4 Argon от Google остановился на 50. Пятёрку лидеров целиком поделили Anthropic и OpenAI.
Главное изменение в самом индексе: теперь 60% оценки дают тесты с закрытыми наборами задач или неопубликованными ответами. Заучить их заранее у модели не выйдет, поэтому цифры честнее, чем раньше. В индекс добавили FrontierCode 2.0 от Cognition, это 132 задачи из настоящих open-source репозиториев, где решение засчитывается, только если мейнтейнер принял бы такой код. Ещё появился Terminal-Bench-Science с 70 научными задачами, которые агент решает в терминале.
В коде Opus 5.5 впереди: 46% в FrontierCode против 42% у Astra. Зато Astra сильнее в науке, у неё 63% в Terminal-Bench-Science и 72% на сложной части CritPt v2.
Самое интересное в цене. Средняя задача индекса обходится в 10,04 доллара у Opus 5.5, в 6,24 у Astra и в 1,27 у Sol. Sol уступает лидеру три балла и при этом почти в восемь раз дешевле. Открытые модели отстали сильнее, чем раньше: лучшая из уже выложенных, DeepSeek V4.1 Flash, набрала 32 балла, на 26 меньше лидера.
Итог простой: первое место у Anthropic, а считать деньги выгоднее с OpenAI.