Baidu открыла модель, которая читает PDF на сотни страниц за раз
Unlimited-OCR 2 распознаёт текст, таблицы и формулы в длинных документах одним запросом. Веса бесплатные, лицензия MIT.
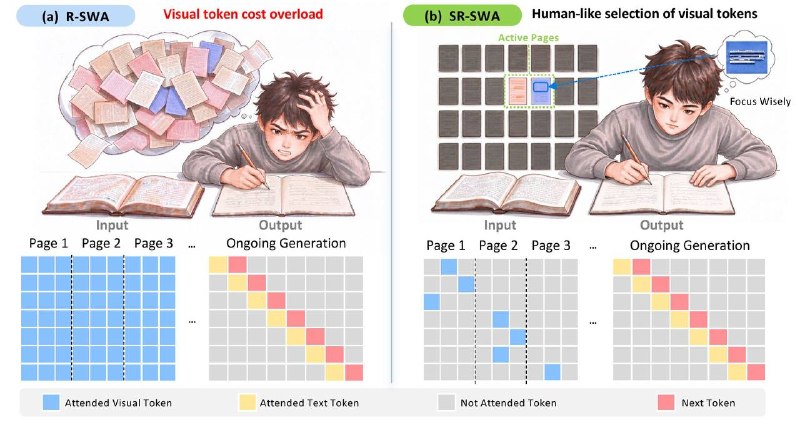
Baidu выложила в открытый доступ Unlimited-OCR 2, модель для распознавания очень длинных документов. Она берёт страницы PDF или сканов по порядку и выдаёт структурированный текст: заголовки, таблицы, формулы, подписи к рисункам и правильный порядок чтения. Книгу, отчёт или пакет договоров на сотни страниц можно отдать одним запросом, а не резать на куски.
Обычно такие модели спотыкаются как раз на длине: чем больше страниц, тем дороже внимание к уже прочитанному, и памяти не хватает. Здесь сделали иначе. Модель держит под рукой фиксированный набор опорных фрагментов, около 512 токенов, и на каждом шаге смотрит только на них. В итоге память и задержка почти не растут, сколько бы страниц ни было. Таблица, начавшаяся на одной странице и продолженная на следующей, при этом не разваливается.
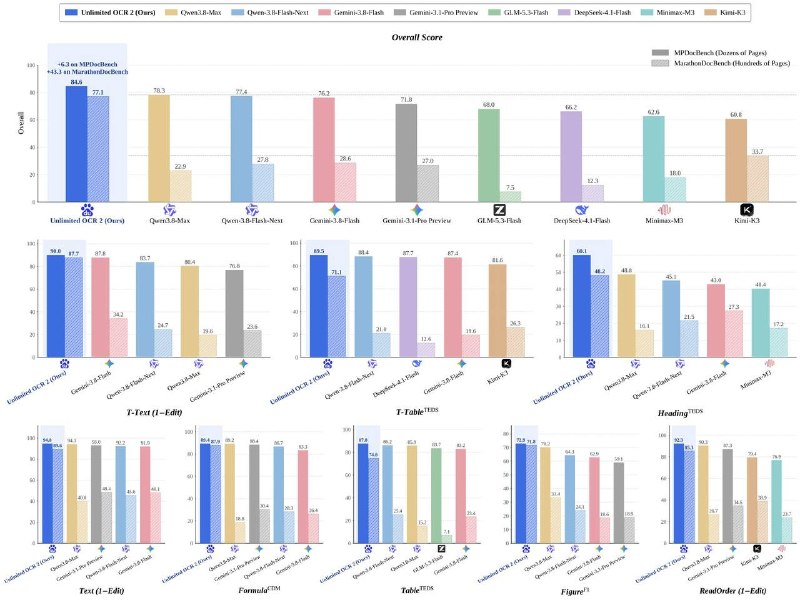
По собственным тестам Baidu, на бенчмарке из документов в сотни страниц модель набрала 77,1 балла, а ближайший соперник Kimi-K3 только 33,7. На документах в десятки страниц разрыв скромнее: 84,6 против 78,3 у Qwen3.8-Max. Слабое место тоже видно: иерархию заголовков на длинных файлах модель угадывает хуже всего. Все цифры пока только от самой Baidu.
Размер 3,3 млрд параметров, веса около 6,7 ГБ, лицензия MIT, то есть можно брать и в коммерческие проекты. Код лежит на GitHub, веса на Hugging Face, запускается через Transformers или SGLang на одной видеокарте.
Если вы до сих пор разбираете длинные PDF вручную или платите за облачный OCR, это повод попробовать.